Hugging Face發佈生物學AI模型,一口氣預測出5.66億個基因位點,預言2027年將成“生物之年”
Anthropic 的旗艦模型 Claude Fable 5.1 設有一套生物學安全機制,當請求被判定為涉及病毒學、毒理學或分子設計等“雙重用途”領域時,就轉由能力較弱的 Claude Opus 5 處理;不設限的同源模型 Claude M
Anthropic 的旗艦模型 Claude Fable 5.1 設有一套生物學安全機制,當請求被判定為涉及病毒學、毒理學或分子設計等“雙重用途”領域時,就轉由能力較弱的 Claude Opus 5 處理;不設限的同源模型 Claude Mythos 5.1 只向經過審核的機構開放。
與閉源模型對 AI 輔助生物探索的收緊相反,10 月初,開源模型託管平臺 Hugging Face 的生物研究團隊 HuggingFaceBio 發佈開源基因註釋模型 Carbon-A,並公開了用它生成的 Carbon 註釋數據庫(CADB)。
數據庫收錄了 48,167 個基因組組裝、22,617 個分類單元,約 27 萬億個鹼基對,預測出約 5.66 億個蛋白編碼位點。作為對照,CADB 的分類單元數約為其訓練數據集、美國國家生物技術信息中心參考序列數據庫(NCBI RefSeq)的 11 倍,序列量是後者約 9 倍,預測出的基因候選數約為 RefSeq 基因註釋總數的 16 倍。
CADB 直接將原本需要單獨立項、耗時數月的物種註釋工作,壓縮為一次查詢請求。在比較基因組學層面,兩萬多個物種也首次有了標準統一的基因圖譜。
Hugging Face 在發佈博客中寫道,主流的 AI 實驗室正在把生物學當作繼網絡安全和數學之後的下一個前沿,“我們認為,2027 年將是屬於生物的一年”。
在 OpenAI、Anthropic 等通用模型廠商都已進入生命科學領域的當下,一家以開源託管著稱的公司親自下場,成為行業押注 AI 生物學的又一力證。
測序數據飛速積累,解讀進程依然緩慢
Carbon-A 彌合的是基因組學領域內一個巨大的裂縫:測序通量的飛速提高和人類理解的落後。
2022 年,因美納(Illumina)宣佈其新一代測序平臺可將人類全基因組測序成本降至約 200 美元;長讀長技術的成熟讓非模式生物的高質量基因組組裝變得可行;地球生物基因組計劃等國際項目的目標是測出所有已知真核物種基因組。組裝數據的積累速度不斷加快。
但測序和組裝的產出是一條由四個鹼基組成的超長字符串,如同一張只有座標、沒有地名的地圖。
註釋要做的,就是在長序列上標出基因的位置,以及其中哪些片段最終會被拼接起來翻譯成蛋白質。這是所有生物功能研究、演化分析、藥物靶點發現的起點。
目前主流的註釋方法仍依賴轉錄組數據、已知蛋白、近緣物種遷移和專家人工校對,是需要逐個物種緩慢推進的手工活,推進速度遠遠落後於測序。在生命樹上,這些證據的分佈也極不均勻:模式生物數據接近飽和,大量冷門物種註釋完成度依然很低。
一個模型,讀懂整棵生命樹
為解決這些難題,Carbon-A 用一個 12 億參數的模型“從頭預測”基因,即只看 DNA 序列、不依賴額外實驗證據,同時覆蓋哺乳動物、其他脊椎動物、無脊椎動物、植物、真菌和原生生物六大類群。
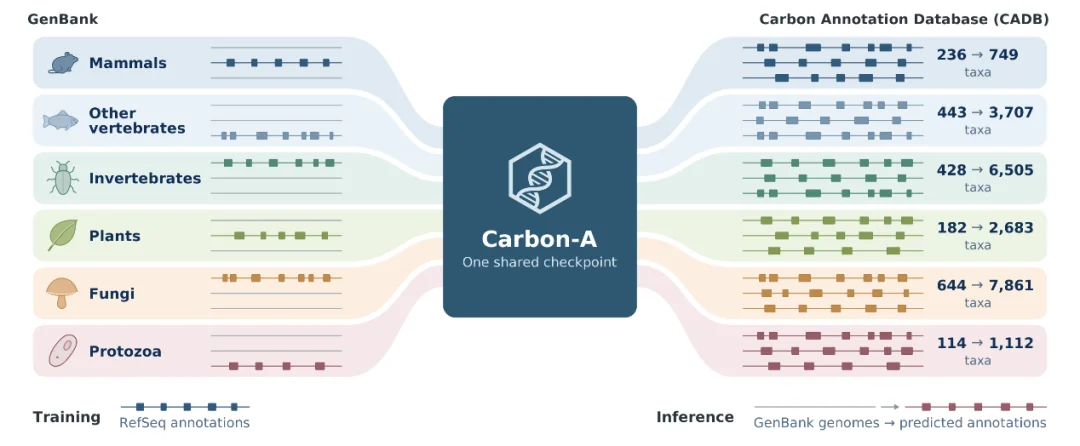
(來源:Hugging Face) 它的底座來自 GENERator(阿里雲、中關村學院等機構 2025 年發佈的長上下文 DNA 生成式基礎模型)。Carbon-A 將其改造為雙向注意力的編碼器,把每 6 個鹼基合併為一個 Token,一次讀入 98,304 個鹼基對的窗口。
輸出端設有正負鏈兩個分類頭,逐個鹼基給出屬於編碼序列(CDS)的概率。後處理管線再把這些概率拼裝成完整的基因模型,併為每個基因打出置信分。訓練數據來自 2,055 個 RefSeq 基因組組裝,團隊還對樣本較少的真菌和原生生物做了額外採樣。
在 42 個基準基因組上,Carbon-A 的宏平均核苷酸級 F1 值(綜合衡量精確率與召回率的指標,滿分為 1)達到 0.944,在核苷酸、外顯子、基因三個層級上均超越了 AUGUSTUS、Helixer、Tiberius、ANNEVO、OrionGeno、SegmentNT 和 NTv3 等主流對照方法。其中,在最嚴苛的基因級標準中,Carbon-A 的 F1 值仍保持在 0.74 左右。
為驗證模型的跨物種泛化能力,團隊開展了兩項壓力測試。其中,僅用動物基因組訓練的版本標註未見過的植物,Carbon-A 的表現依然出色;而對於遺傳密碼與其他生物顯著不同的嗜熱四膜蟲,Carbon-A 無需專門適配,核苷酸級 F1 值也能達到 0.960。
這證明該模型已經學到了編碼序列的底層規律,而非“死記硬背”、照搬某個類群特有的經驗法則。
用 RefSeq 訓練模型還有一個繞不開的問題:參考註釋本身並不完美。模型如果只能記住靜態的訓練標籤,很容易學到錯誤的內容,且無法及時更新。
對此,藉助新版豬基因組組裝推出的時機,研究人員設計了一組實驗:Carbon-A 使用的是 2017 年版豬基因組組裝,訓練結束後,2026 年版高質量組裝發佈。但結果顯示,模型在新組裝上的表現反而好於舊組裝——它或許比人類更懂基因組。
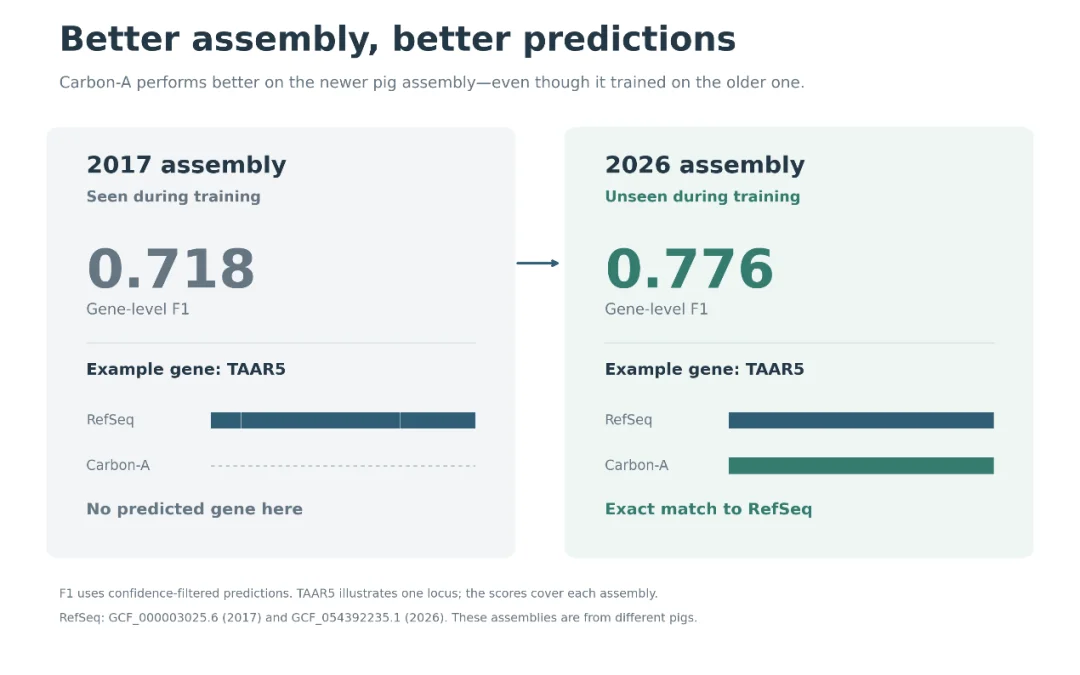
(來源:Hugging Face) 最有價值的預測在於模型與參考庫的不一致之處:RefSeq 裡沒有、Carbon-A 卻找出來的編碼區,究竟是新發現還是假陽性?
對於這一問題,Hugging Face 聯合加州大學聖迭戈分校(UCSD)等機構,對貓、敘利亞倉鼠、雞和擬南芥做了 PacBio 全長轉錄本測序(Iso-Seq,可直接讀取活細胞中完整 RNA 分子的技術)。
在這四個已深入研究的物種中,有 239 個未被 RefSeq 收錄的候選基因得到了 RNA 證據支持,Carbon-A 預測的完整編碼序列獲得轉錄組支持的比例約為 0.62,明顯高於其他從頭預測工具。
長期以來,基因預測工具以“與 RefSeq 的吻合程度”論高下,參考庫默認就是標準答案。而 Carbon-A 直接改變了固有的裁判關係:模型和參考庫各自提出關於基因位置的假設,由細胞中實際存在的 RNA 來判定。即便是積累了幾十年的人工註釋,模型仍能從中找出遺漏的基因。
至於這些序列能否被翻譯成蛋白、蛋白承擔什麼功能,團隊計劃用核糖體圖譜和質譜繼續驗證,並表示即將發佈一批針對此前未經研究物種的溼實驗結果。
一個刻意開放的選擇
Carbon-A 並不是首個用 AI 加速基因組註釋的模型。近期,華大研究院發佈的 OrionGeno 將系統發育信息引入深度學習,10 天註釋了 1,249 個真核生物科的代表性基因組;西安交通大學葉凱團隊發表的 ANNEVO 則把註釋一個人類基因組的時間壓縮到一個半小時,擬南芥僅需 3 分鐘。
但與以上工具需要研究者手動部署運行不同,Carbon-A 一次性給出了覆蓋兩萬多個物種、可直接查詢的詳細公共數據庫。數據庫中的每條預測都附帶組裝編號、基因組座標、重建的編碼序列、翻譯出的蛋白序列和置信分。
這種從模型到產出數據的全面開放,是 Hugging Face 刻意做出的選擇。團隊在博客中直言,研究者依賴封閉前沿模型時,整個生態會顯得十分脆弱。他們還點名了納維-斯托克斯方程風波,以及 Claude 此前拒絕回答正當生物學問題的爭議。
閉源實驗室收緊生物學能力、實行分級授權,自然有一定的安全考量。但這些事件不禁讓科研人員開始擔心,自己的研究方向可能會在與 AI 的對話中流向模型公司;更進一步,科學家使用 AI 工具的權力都可能落入少數幾家模型公司手中。
而 Hugging Face 選擇的是一個安全代價極低的領域:Carbon-A 只回答“基因在哪裡”,不設計 DNA,也不預測基因功能。在這一層,開放帶來的收益遠大於潛在風險。今年 5 月,由科學 AI 負責人喬治婭·錢寧(Georgia Channing)帶領的團隊還開源了 Carbon 系列 DNA 生成模型,Carbon-A 已是第二組產出。
不過,Carbon-A 目前預測的是編碼區的佔位,無法解析一個基因產生的多條轉錄本和可變剪接,適用範圍限於真核生物。
團隊在模型原始輸出中已觀察到與可變剪接相關的信號,顯式建模多轉錄本被列為下一步重點。數據庫方面,模型目前已完成目標基因庫(GenBank,NCBI 維護的公開核酸序列數據庫)基因組集合的約一半,下一批數據計劃三週後發佈。
當“找基因”從週期漫長的繁重工作,變成在電腦上輕點即可實現的查詢過程,生命科學的門檻會轉移到下一環:揭示這些基因究竟發揮了怎樣的功能?
在 Carbon-A 找出的 5.66 億個候選位點中,絕大多數只有座標和推斷出的蛋白序列,背後的生物學功能仍是空白。
截至目前,核糖體圖譜、質譜、基因編輯等驗證手段的通量,遠遠無法追趕模型生成假設的速度。Hugging Face 口中的“生物之年”能否到來,將取決於行業能否推動後續工作的自動化,讓實驗能力跟上計算產出。
參考內容:
https://huggingface.co/blog/HuggingFaceBio/carbon-annotator-genbank-genome-annotation
https://huggingface.co/HuggingFaceBio/Carbon-A-1.2B
https://huggingface.co/collections/HuggingFaceBio/carbon-annotation-database
https://arxiv.org/abs/2502.07272
https://huggingface.co/collections/HuggingFaceBio/carbon
https://db.cngb.org/data_resources/project/CNP0009228
https://www.nature.com/articles/s41592-026-03036-7
運營/排版:何晨龍
注:封面/首圖由 AI 輔助生成
參考來源:麻省理工科技評論 · 17091(轉載自 DeepTech深科技)
免責聲明:轉載僅供信息參考,版權歸原作者及原媒體所有。