Meta 發佈 Muse Wonder、Wonder Full:AI Agent 模型效能大幅提升,挑戰 OpenAI、Claude
Meta 2026 年 10 月 12 日推出 Muse Wonder 與 Wonder Full,強化長期記憶、複雜任務與專業分析;Intelligence Index v4.3 達 56 分。API 與 Muse Code 已部分開放。
Meta 於 2026 年 10 月 12 日正式推出新一代 AI 模型 Muse Wonder 與 Muse Wonder Full,聚焦個人與企業 AI Agent 應用,強化長期記憶、複雜任務執行、程序開發,以及法律、金融、醫療等專業分析能力。
消息公佈後,Meta 股價盤中一度上漲約 4%,最終收漲 3.38% 至 742.96 美元。此次更新由 Meta Superintelligence Labs(MSL) 主導,在 Prometheus 大型數據中心完成訓練,也是 Meta 推動「Personal Superintelligence(個人超級智能)」策略的重要一步。
目錄
重點整理
- Muse Wonder 系列針對多步驟規劃、工具操作、長時間執行的 Agent 工作流優化。
- Muse Wonder Full 在 Artificial Analysis Intelligence Index v4.3 得 56 分,官方稱僅次於 Claude Opus 5.5(58 分)。
- 兩款模型均支持約 100 萬 Token 上下文;輸入含文字、圖片、視頻、音頻。
- Muse Wonder 已通過 Meta Model API 開放;Wonder Full 主要面向 Muse Code 訂閱用戶。
- 底層模型與 9 月推出的個人 Agent 產品「Muse」屬不同產品層級。
Muse Wonder 是什麼
Muse Wonder 是 Meta 的新一代前沿(Frontier)AI 模型系列,這次同步推出兩個版本:
| 比較項目 | Muse Wonder | Muse Wonder Full |
|---|---|---|
| 產品定位 | 高階通用與代理式 AI 模型 | 更高能力的旗艦版本 |
| 核心應用 | 個人助理、研究、文件分析、程序開發 | 複雜任務、專業知識工作、長時間軟件工程 |
| 上下文長度 | 100 萬 Token | 100 萬 Token |
| 輸入模態 | 文字、圖片、視頻、音頻 | 文字、圖片、視頻、音頻 |
| Meta Model API | 已開放 | 尚未公開提供 |
| Muse Code | 已開放 | 訂閱用戶可使用 |
| Intelligence Index v4.3 | 52 分 | 56 分 |
資料來源:Meta 官方 Model Card、Artificial Analysis
Meta 已宣佈未來將逐步把新模型導入 Muse App,優先向訂閱用戶開放。
四大核心能力
Meta 在官方研究報告中將技術重點分為四個方向,其中 Active Memory(主動記憶) 與 Active Focus(主動聚焦) 是此次最受關注的更新。
1. Active Memory:跨對話延續脈絡
模型可跨對話保存重要信息,並根據當前任務找回相關內容(例如旅遊偏好、工作目標),減少重複提供背景。Meta 以 MemoryBench 測試在干擾信息與事實更新下能否準確找回關鍵內容。
2. Active Focus:長時間任務與糾錯
強化 AI 長時間執行任務的能力:遇障礙時嘗試其他方法、修正錯誤,必要時向用戶確認。適用保險申請、複雜文件與跨平臺流程。評測包括 FocusBench 與 SWE-Marathon(長時間軟件工程)。
3. Domain Expertise:法律、金融、醫療
可協助整理合約條款、研究財務資料、分析專業文件併產出工作草稿。Meta 採用 Harvey LAB、Vals Finance Agent V2 等基準評估專業知識工作表現。
4. Frontier Coding:長時間開發與軟件工程
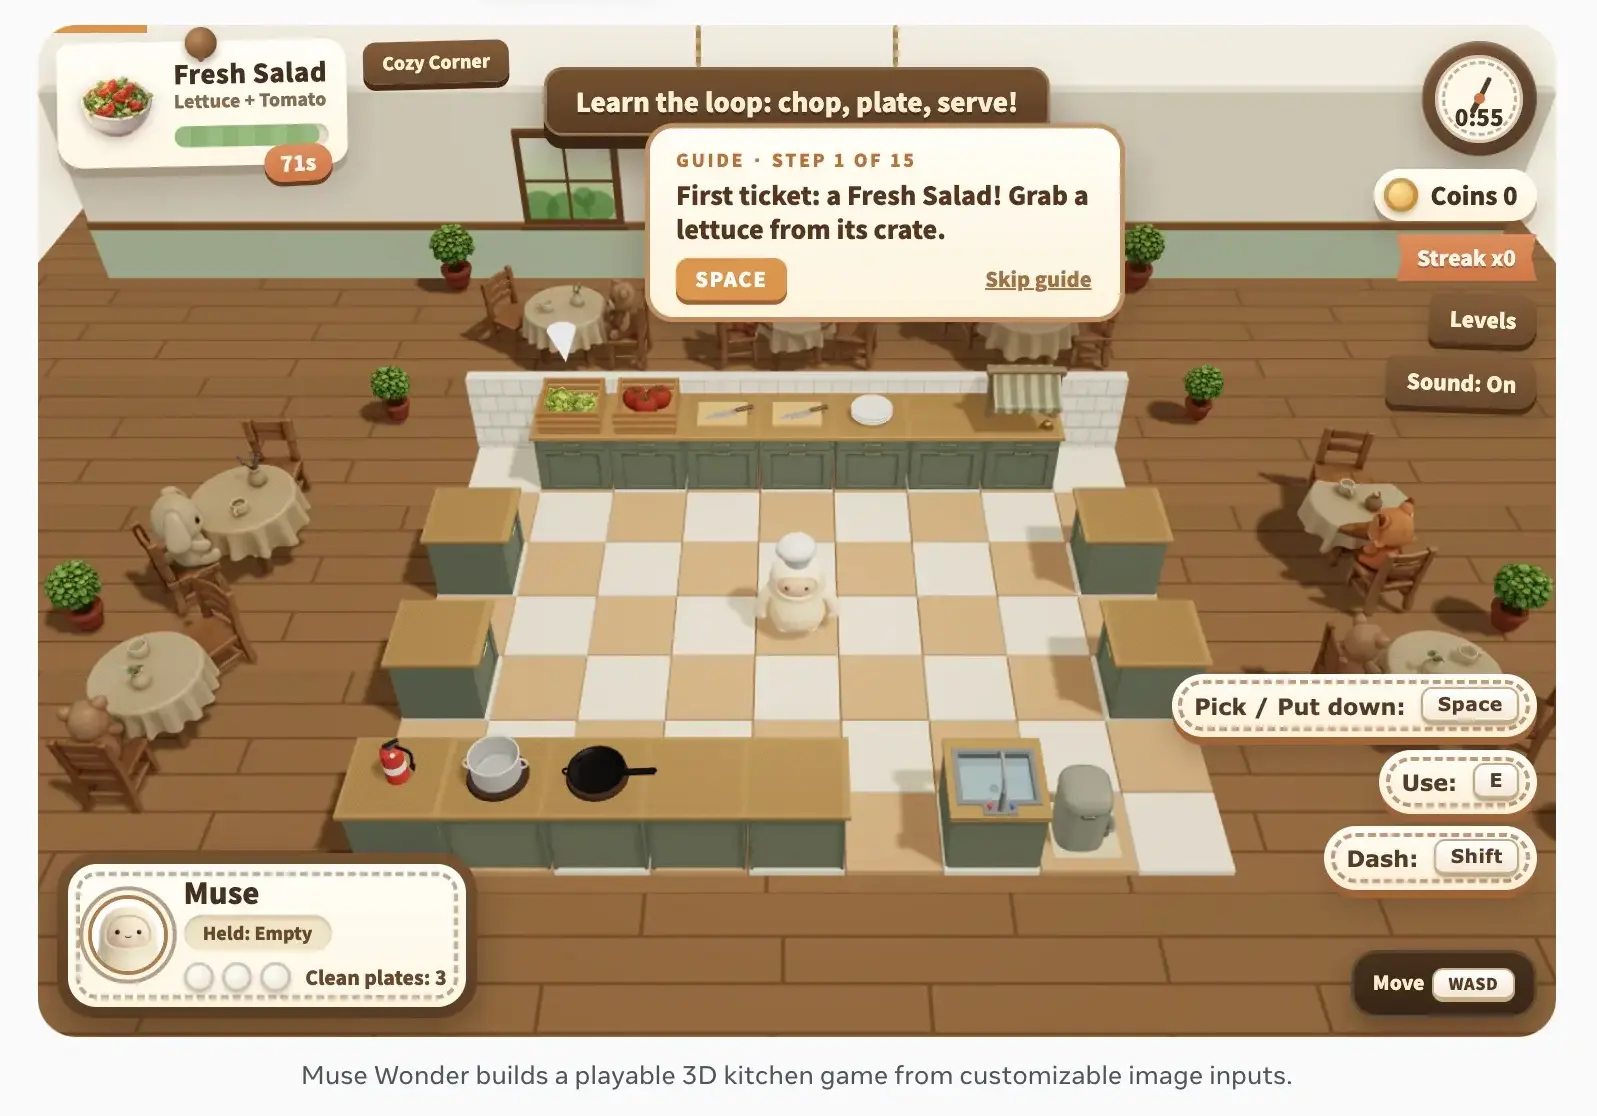
支持跨文件修改、除錯、測試與長時間開發;官方曾展示根據圖片生成可遊玩的 3D 廚房遊戲,體現從視覺理解到互動應用的能力。
評測與效能比較
根據 Artificial Analysis 2026 年 10 月 12 日評測,Muse Wonder Full(56 分) 在 Intelligence Index v4.3 中僅次於 Claude Opus 5.5(58 分),官方解讀稱領先 GPT-6 Astra 與 Gemini 4 Argon 等競品(具體名次以第三方完整榜單為準)。
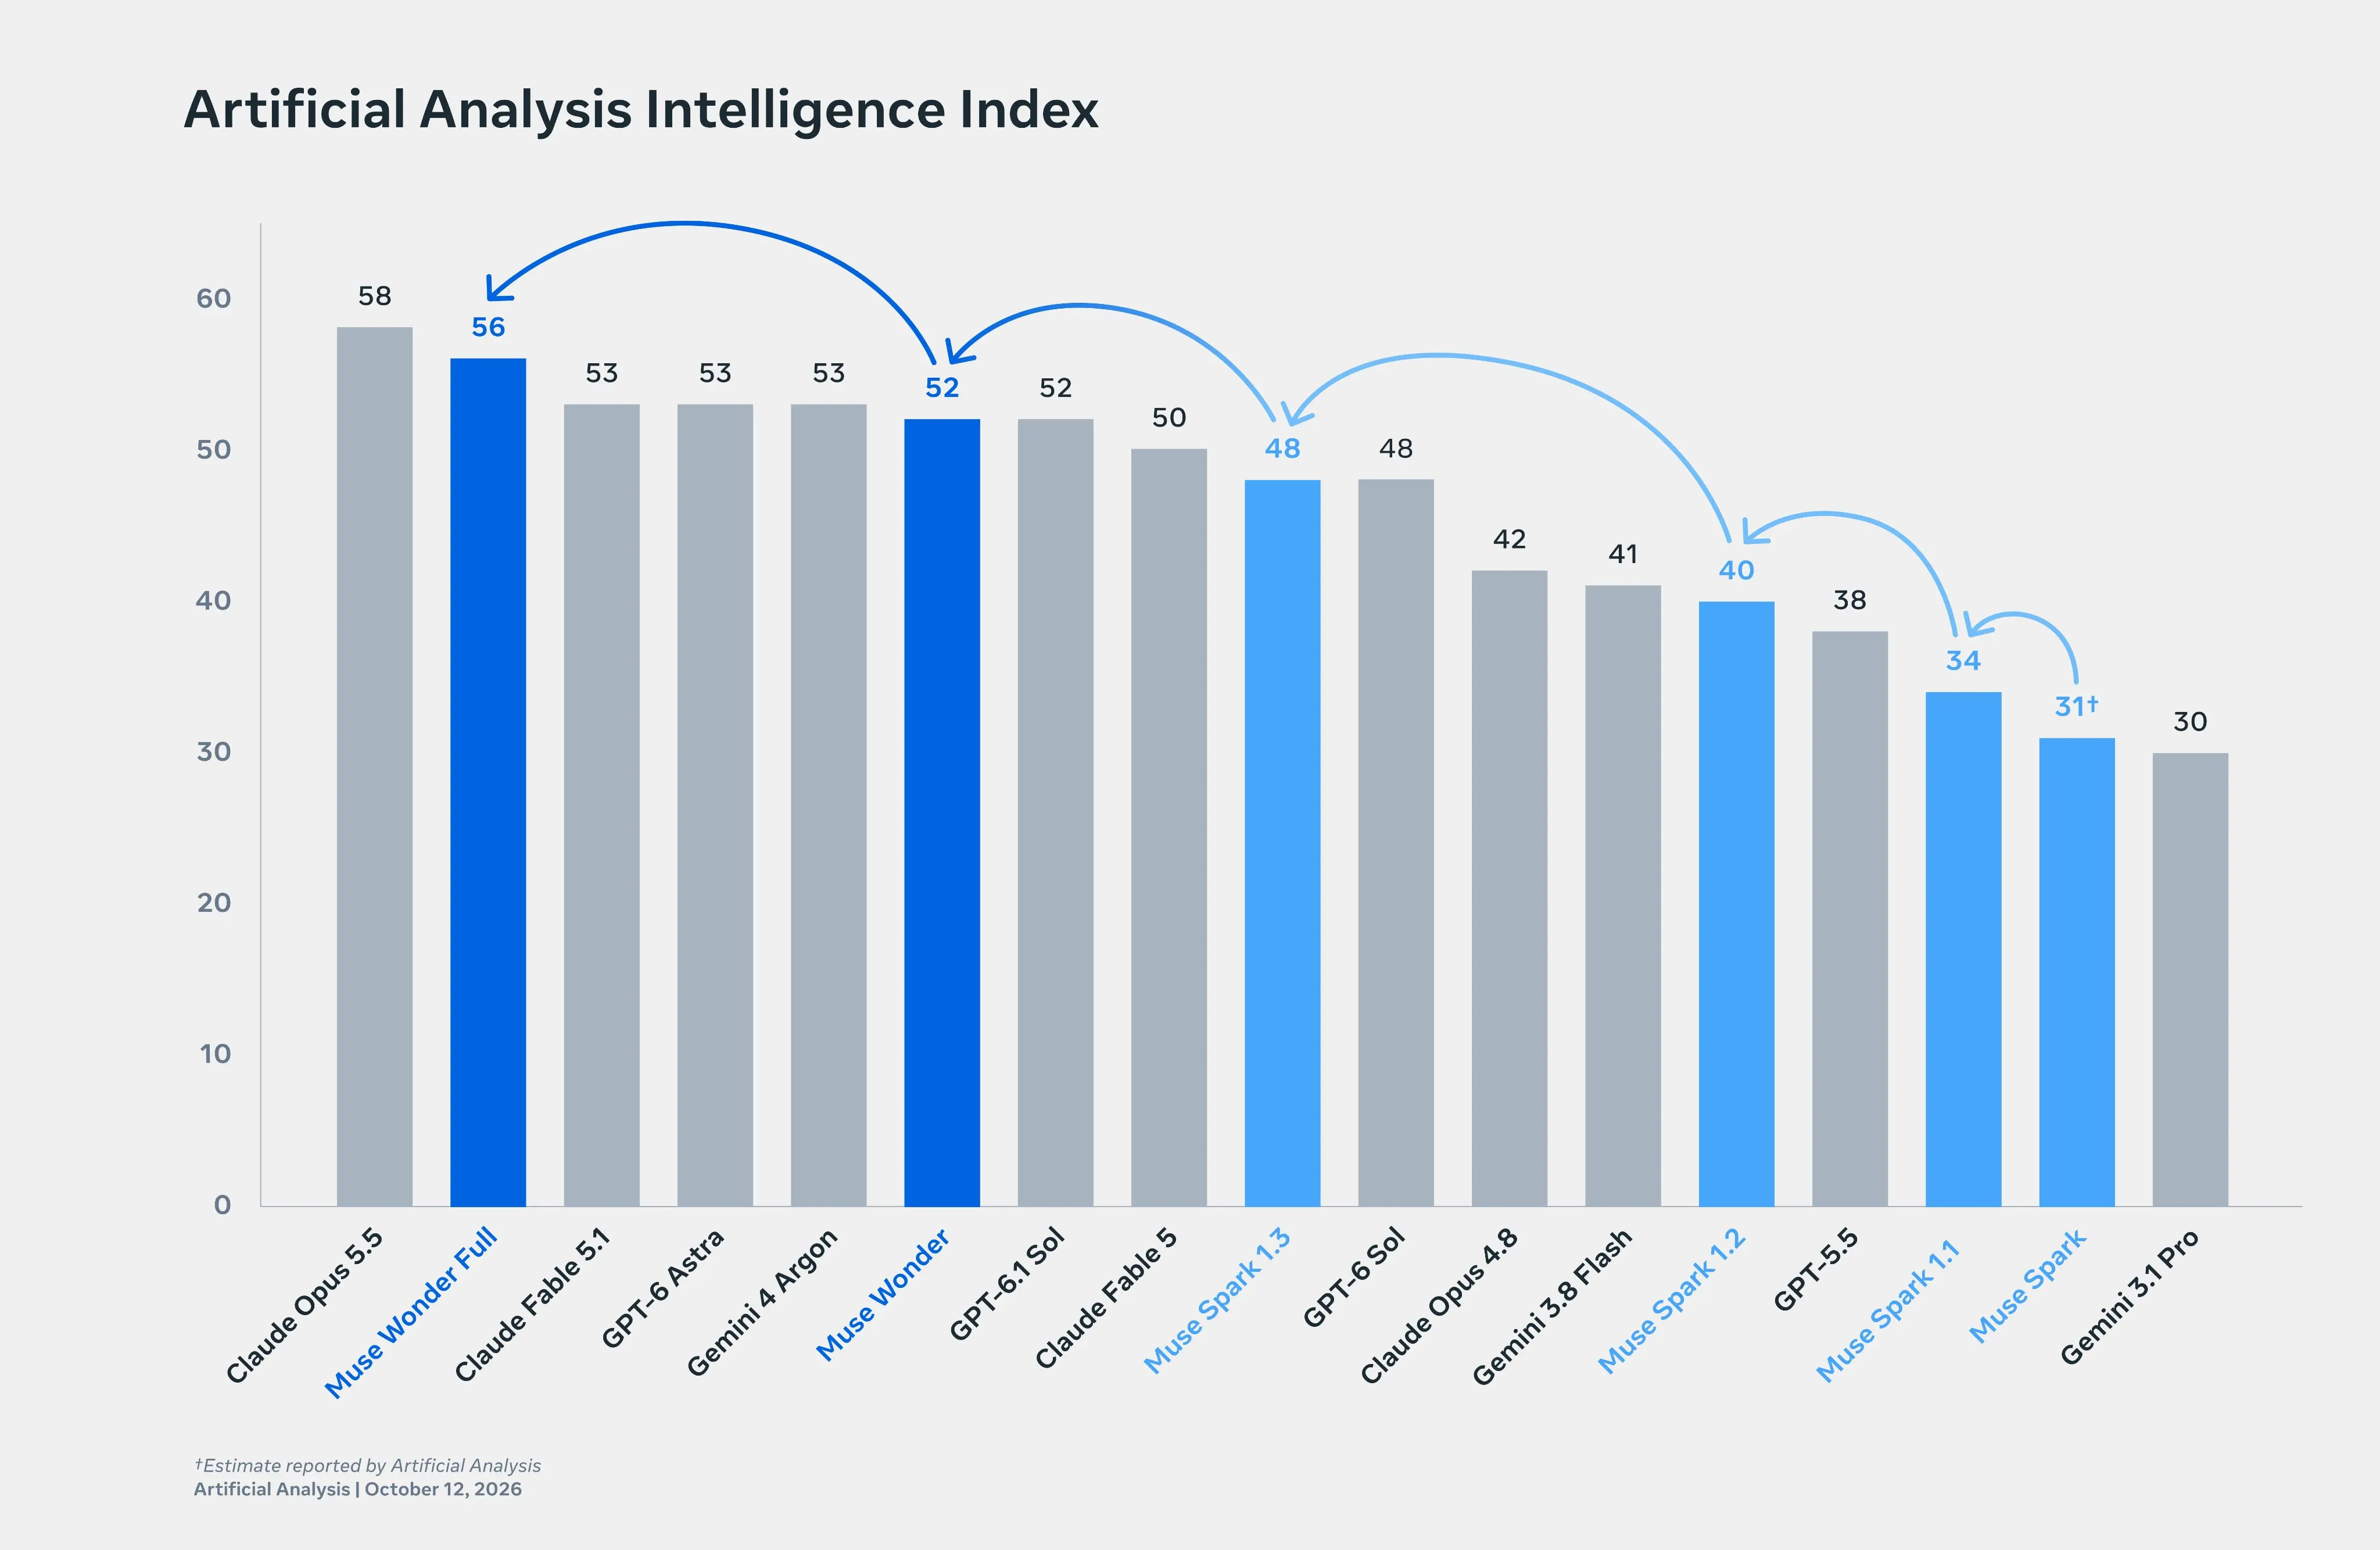
Muse Wonder Full 相對 Muse Spark 1.3 的部分對比(Artificial Analysis):
| 評測項目 | Muse Spark 1.3 | Muse Wonder Full | 變化 |
|---|---|---|---|
| Intelligence Index v4.3 | 48 | 56 | +8 分 |
| Terminal-Bench 4.0 | 33% | 57% | +24 百分點 |
| GDPval-AA v2.1 | 1,681 Elo | 1,857 Elo | +176 Elo |
| AA-Briefcase | 1,581 Elo | 1,729 Elo | +148 Elo |
Terminal-Bench 成功率由 33% 提升至 57%,反映終端操作與工程類任務能力加強;專業工作與多步驟 Agent 任務 Elo 亦同步上升。
三項 Agent 應用示範
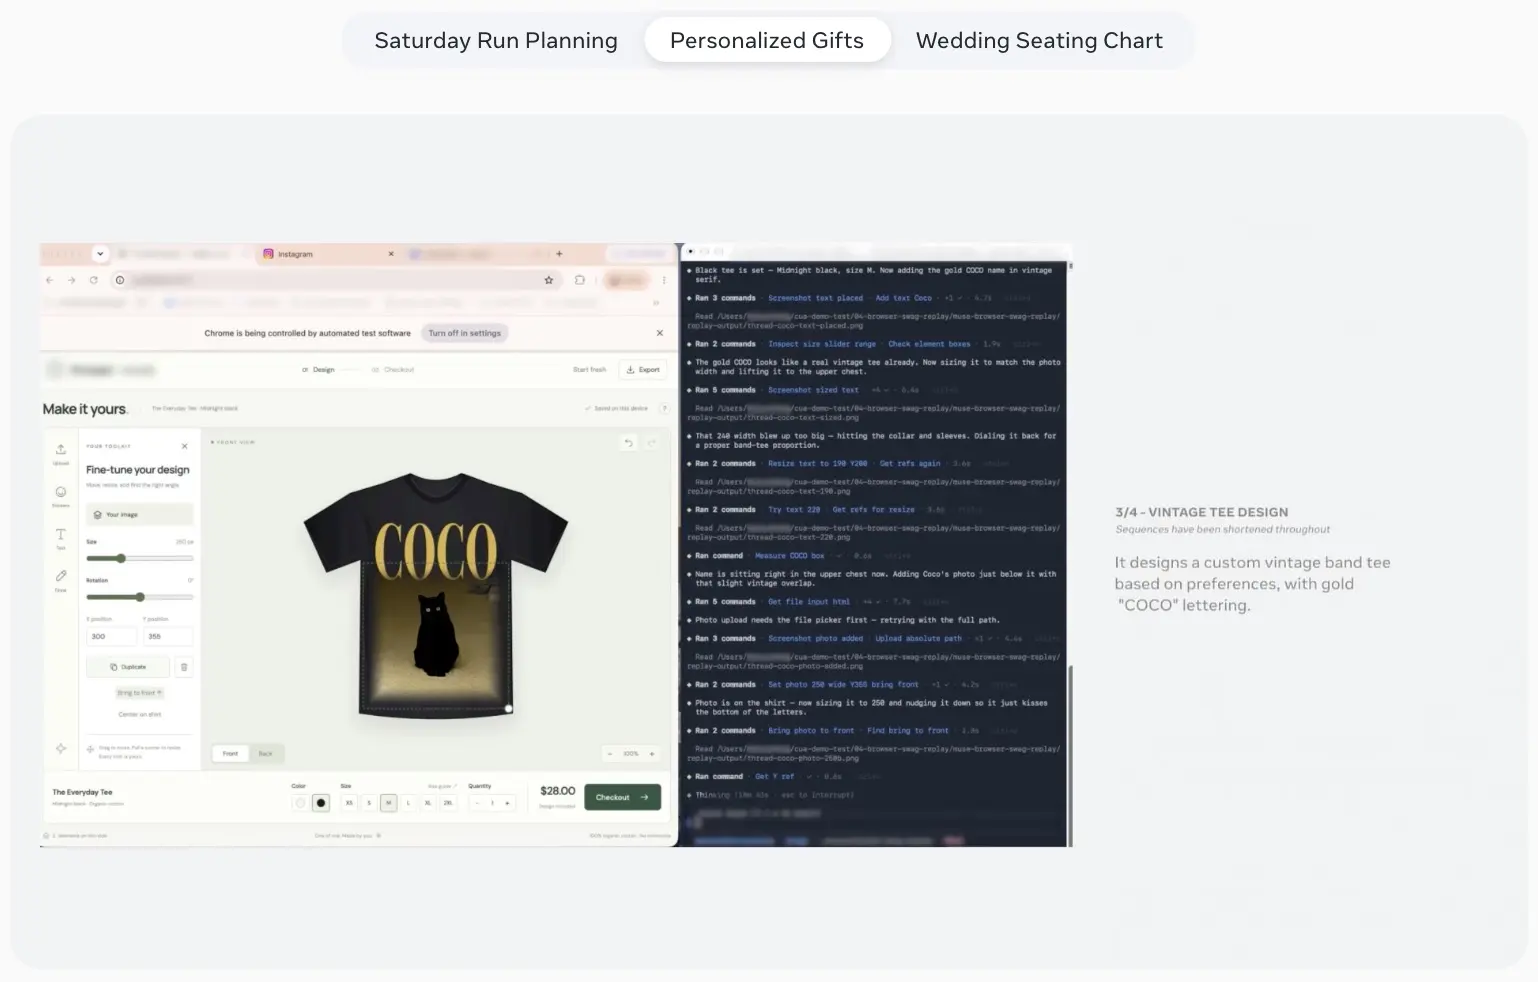
Meta 官方示範如何將個人信息、推理與外部工具結合:
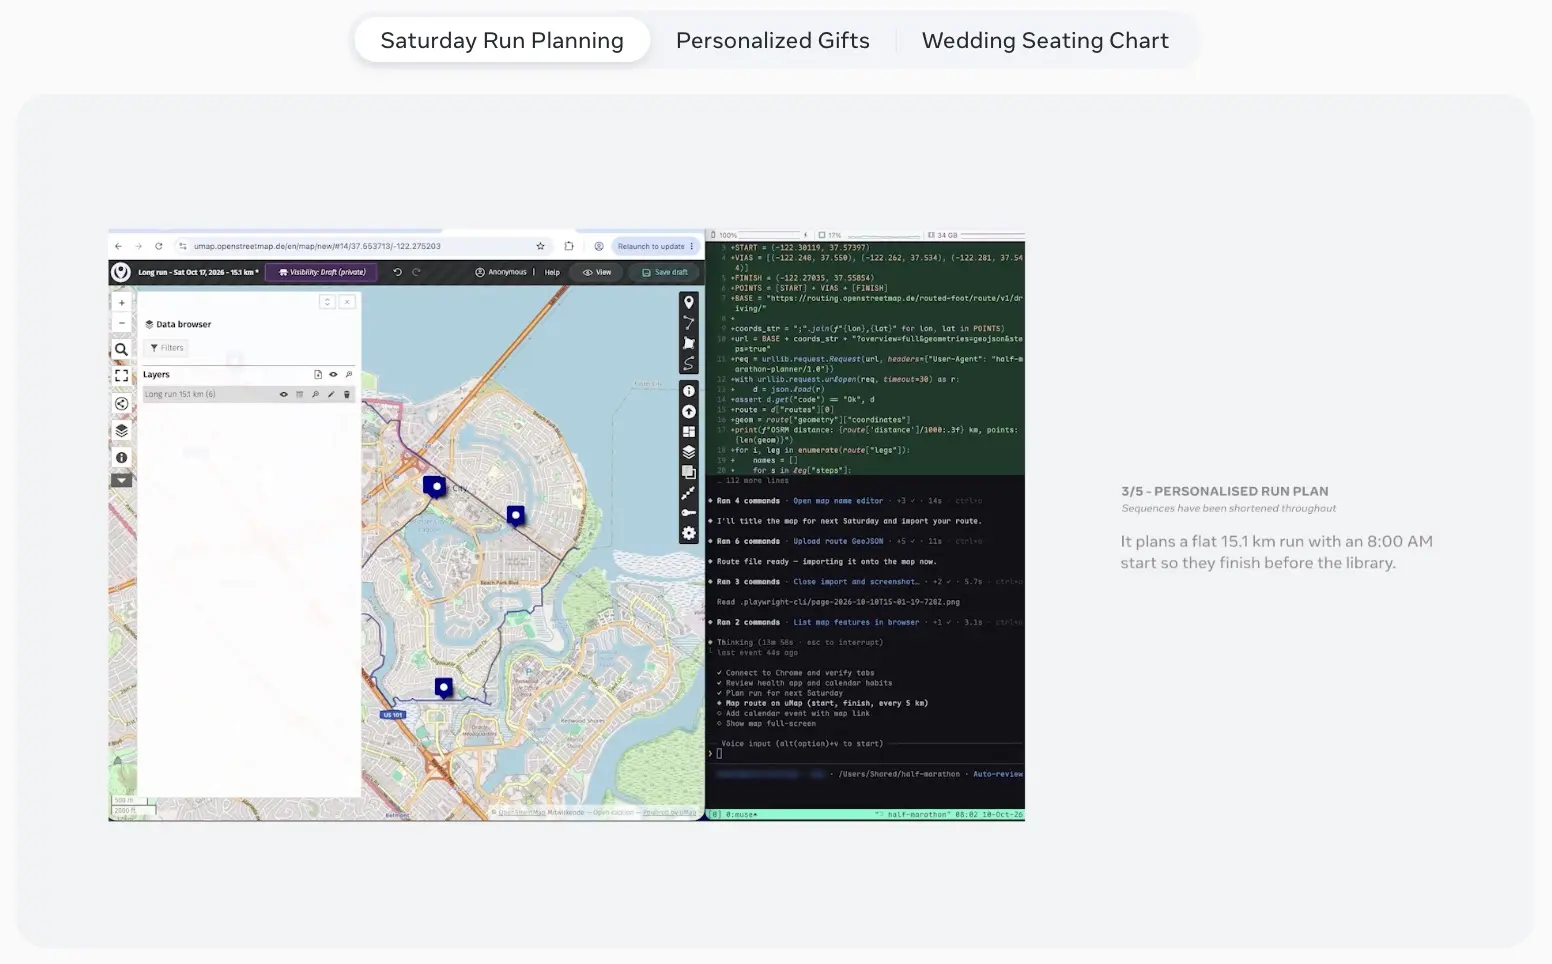
- 個性化跑步計劃:依偏好透過瀏覽器與應用規劃路線,展示跨平臺操作。
- 定製化禮品:參考個人照片設計並訂購商品,結合視覺理解與購物流程。
- 婚禮座位安排:依賓客名單與配對條件產生座位表,展示條件推理與規劃。
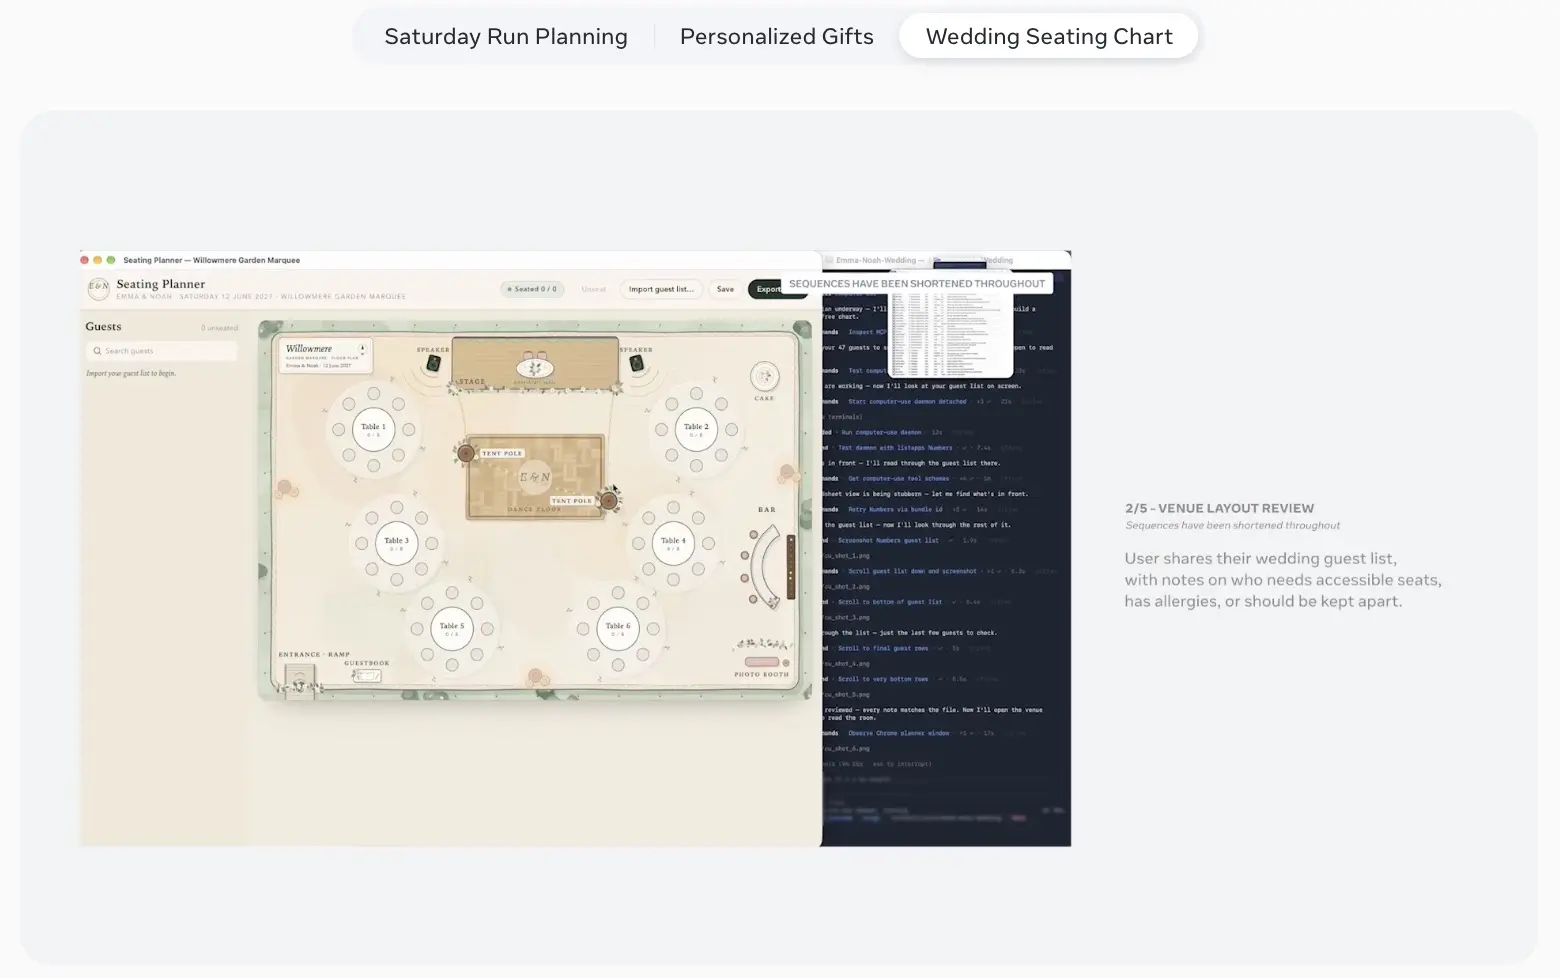
完整影片與互動展示可於 Meta Research 官方頁面查看。
怎麼使用
截至 2026 年 10 月 13 日,開放情況摘要如下:
| 管道 | 開放情況 | 適用對象 |
|---|---|---|
| Meta Model API | Muse Wonder 已開放 | 開發者、企業 |
| Muse Code | Wonder 已開放;Full 限訂閱 | 程序開發者 |
| Muse App | Wonder 即將導入,訂閱優先 | 一般用戶 |
臺灣用戶:Meta 尚未公佈 Muse App 全面開放時程;FAQ 亦指出一般用戶暫無法透過 App 使用 Wonder 系列。API 與 Muse Code 依官方資格、計費與地區政策為準,使用前請查閱 Meta 文檔。
Meta 規劃為不同 Agent 任務訓練專用模型,讓工作流由更合適的模型處理。
隱私與安全
隨著 Agent 可能接觸消息、日曆與私人文件,Meta 稱已對敏感信息、惡意指令與網絡安全風險進行評估,並依 Meta Superintelligence Scaling Framework 審查。Model Card 指部署防護後,多項重大風險領域剩餘風險評為「中度或以下」,但模型仍可能判斷或執行錯誤;涉及金融交易、個人資料傳輸等操作,建議保留人工確認。
值得關注的爭議
社區(X、Reddit、Hacker News 等)對 Muse Wonder 反應兩極:有人肯定 Coding 與 Agent 評測進步,尤其 Active Memory / Active Focus 對長期任務的潛力;也有開發者質疑 Benchmaxxing(過度針對基準優化),認為高分未必等於日常體驗。
Wonder Full 的訂閱門檻、Token 消耗與額度也是討論焦點——部分早期用戶反映相同任務額度消耗高於 Claude Opus 5.5,仍屬發佈初期個別經驗,有待更多獨立測試。
整體而言,Meta 正從 Llama、Muse Spark 到 Wonder 系列,構建模型、雲端執行與終端應用的 AI 生態;接下來能否把評測優勢轉化為穩定且具成本效益的產品體驗,將是關鍵。
FAQ
Muse Wonder 和 Wonder Full 有什麼差別?
Wonder 面向開發與一般代理工作,可通過 Meta Model API 與 Muse Code 使用;Wonder Full 評測分數更高,目前主要提供給 Muse Code 訂閱用戶。
支持多少 Token?
兩款均支持最高約 100 萬 Token 上下文,可處理大型文件與長篇代碼。
臺灣可以用 Muse App 嗎?
官方尚未公佈臺灣開放時程;Wonder 系列在 App 端仍以「即將導入、訂閱優先」為主,實際以 Meta 公告為準。
可以免費使用嗎?
Muse Wonder 通過 API / Muse Code 付費使用(API 依 Token 計費);Wonder Full 限特定付費訂閱。不是開源權重公開下載。
是開源模型嗎?
Meta 尚未宣佈公開 Wonder / Wonder Full 模型權重,目前主要通過官方 API 與 Muse Code 提供。
免責聲明:不構成投資建議;AI 產品功能與價格以官方為準。